Como usar o pdf24 OCR PDF em 4 passos
- Abra a digitalização. Toque em Selecionar um PDF ou imagem e escolha um PDF digitalizado ou a foto de uma página (JPG, PNG, WebP), ou solte-o na caixa.
- Confira o idioma. Escolha o idioma do texto entre 11 opções; a lista começa no idioma desta página.
- Escolha o resultado. PDF pesquisável mantém as páginas e acrescenta texto oculto; Texto simples salva só as palavras num arquivo .txt.
- Execute e baixe. Toque em Executar OCR, espere enquanto cada página é reconhecida e salve o arquivo -ocr.pdf ou .txt.
O que o pdf24 OCR PDF muda num arquivo digitalizado?
O pdf24 OCR PDF mantém cada página original intacta e acrescenta uma camada invisível de palavras reconhecidas, posicionadas sobre as letras correspondentes. Os visualizadores então deixam você pesquisar, selecionar e copiar o texto, enquanto a página continua mostrando a digitalização original. Palavras com confiança muito baixa ficam de fora, em vez de serem adivinhadas.
“Optical character recognition (OCR) or optical character reader is the electronic or mechanical conversion of images of typed, handwritten or printed text into machine-encoded text (o reconhecimento óptico de caracteres é a conversão eletrônica ou mecânica de imagens de texto datilografado, manuscrito ou impresso em texto codificado por máquina)”
| Arquivo | Resultado | Palavras | Antes → depois | Tempo |
|---|---|---|---|---|
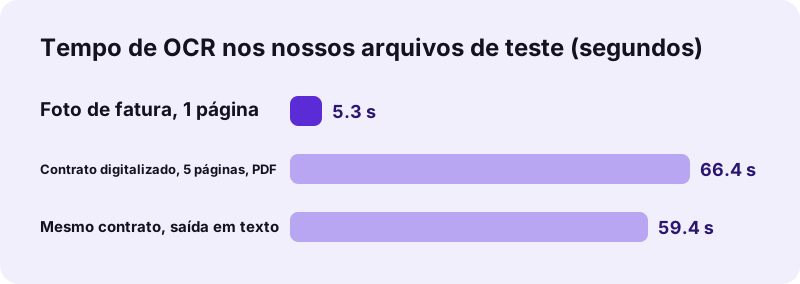
| Foto de fatura (PNG, 1 página) | PDF pesquisável | 54 | 72 KB → 105 KB | 5,3 s |
| Contrato digitalizado (PDF, 5 páginas) | PDF pesquisável | 2.575 | 2,46 MB → 2,60 MB | 66,4 s |
| Mesmo contrato | Texto simples | cerca de 2.591 | → .txt de 14 KB | 59,4 s |
pdf24 OCR PDF: precisão numa digitalização limpa
Conferimos palavra por palavra o texto do pdf24 OCR PDF no contrato de 5 páginas contra as palavras do documento original: todas as 2.565 palavras alfabéticas eram palavras reais da fonte, sem nenhuma lida errado. Antes do OCR, uma busca por thirty encontrou 0 ocorrências na digitalização; depois do OCR, a mesma busca encontrou 150. A foto da fatura voltou com o texto exato, incluindo valores como 319.70.
pdf24 OCR PDF no celular
O pdf24 OCR PDF também roda no celular, mas é um trabalho pesado: cada página é renderizada a cerca de 300 dpi e analisada pelo motor de reconhecimento no próprio aparelho. Espere que um celular demore mais que os 13 segundos por página do nosso notebook, mantenha a tela ligada e comece com poucas páginas.
pdf24 OCR PDF no computador
No computador, digitalizações longas são viáveis: nosso contrato de 5 páginas levou pouco mais de um minuto. A linha de progresso mostra qual página está sendo lida. A primeira execução de uma sessão também baixa os dados do idioma uma vez, e é por isso que a nossa foto de 1 página levou 5,3 segundos.
pdf24 OCR PDF: dica para resultados melhores
Digitalize a 300 dpi, mantenha as páginas retas e use a limpeza Documento ou Preto e branco em Digitalizar para PDF nas fotos de celular. Contraste limpo e linhas retas importam mais para o reconhecimento do que a cor.
Quais idiomas o pdf24 OCR PDF reconhece?
O pdf24 OCR PDF reconhece 11 idiomas: inglês, francês, espanhol, português, alemão, italiano, russo, árabe, indonésio, turco e vietnamita. Escolha o idioma em que o documento foi escrito; a lista começa no idioma da página em que você está. Um idioma errado custa principalmente acentos e letras especiais, como ç, ã e õ.
| Idioma | Escrita | Observação |
|---|---|---|
| Inglês, francês, espanhol, português, alemão, italiano, indonésio, turco, vietnamita | Latina com acentos | Escolha o idioma exato por causa dos acentos (é, ç, ß, ş, ơ) |
| Russo | Cirílica | Palavras em letras latinas no texto são lidas com menos confiança |
| Árabe | Árabe, da direita para a esquerda | Uma fonte árabe é embutida para a camada de texto |
pdf24 OCR PDF com documentos em vários idiomas
Um idioma é usado por execução. Para uma carta em português com nomes em inglês, escolha português: nomes em letras latinas continuam sendo reconhecidos. Para documentos em duas escritas, como árabe e inglês, rode o idioma predominante; a outra escrita pode sair incompleta.
O pdf24 OCR PDF é privado se baixa um motor?
O pdf24 OCR PDF baixa o motor de reconhecimento e os dados do idioma de uma biblioteca de código pública no primeiro uso, mas o seu arquivo nunca faz o caminho inverso: as páginas são lidas, renderizadas e reconhecidas no seu aparelho. Nossas execuções mostraram 0 bytes enviados, inclusive no contrato de 2,46 MB.
O motor é o Tesseract, compilado para rodar dentro do navegador. Baixar código e dicionários é como carregar uma fonte; nada do seu documento vai nessas requisições. A File API no MDN explica como uma página lê um arquivo local sem enviá-lo.
“Tesseract is an optical character recognition engine for various operating systems. It is free software, released under the Apache License. (O Tesseract é um motor de reconhecimento óptico de caracteres para vários sistemas operacionais. É software livre, lançado sob a Licença Apache.)”
Por que o pdf24 OCR PDF encontra palavras erradas ou nenhuma palavra?
O pdf24 OCR PDF depende do que a página mostra. Fotos borradas, letras miúdas, manuscritos, carimbos pesados e o idioma errado reduzem a precisão. Imagens sem texto podem até gerar palavras sem sentido: nossa página de teste com formas coloridas aleatórias devolveu 457 palavras sem significado. Digitalizações limpas e retas de texto impresso dão os melhores resultados.
| Problema | Solução |
|---|---|
| Nenhum texto foi reconhecido | Confira o idioma e verifique se a página não está de cabeça para baixo; gire-a com Girar páginas do PDF |
| Muitas letras erradas | Digitalize de novo a 300 dpi ou limpe a foto com Digitalizar para PDF |
| Manuscrito não é lido | O motor é treinado em texto impresso; manuscritos não são suportados |
| Palavras sem sentido em fotos ou gráficos | Apague-as na saída de texto, ou rode o OCR só nas páginas de texto |
| O arquivo já tem texto | Não precisa de OCR: use Copiar texto do PDF ou Pesquisar em PDF |
pdf24 OCR PDF e o que fazer em seguida
Um PDF pesquisável do pdf24 OCR PDF abre caminho para as outras ferramentas de texto. Próximos passos típicos depois do OCR:
- Encontre cada menção a um nome ou valor com Pesquisar em PDF.
- Copie o texto inteiro com Copiar texto do PDF.
- Transforme a digitalização num documento editável com PDF para Word.
- Compare duas versões digitalizadas com Comparar PDF, depois do OCR nas duas.
- Reduza o resultado com Comprimir PDF se ele precisar caber num e-mail.
pdf24 OCR PDF: perguntas frequentes
O pdf24 OCR PDF é grátis?
Sim. O OCR no pdf24tools é grátis, sem conta, sem marca d'água e sem limite de páginas. O reconhecimento roda no seu navegador, no seu próprio aparelho, então não há tempo de servidor para cobrar. Documentos longos só demoram mais, cerca de 13 segundos por página no nosso notebook.
O pdf24 OCR PDF envia a minha digitalização?
Não. A página baixa uma vez o motor de reconhecimento e os dados do idioma, mas o seu arquivo nunca é enviado: nossas linhas de resultado mostraram 0 bytes enviados em toda execução. As páginas são renderizadas e reconhecidas no seu aparelho, e nada fica guardado depois que você fecha a aba.
Quanto tempo o pdf24 OCR PDF leva?
No nosso notebook Windows, cerca de 13 segundos por página: 66,4 segundos para um contrato digitalizado de 5 páginas e 5,3 segundos para a foto de uma fatura de 1 página, incluindo o download único do idioma. Celulares são mais lentos. A linha de progresso mostra qual página está sendo reconhecida.
O pdf24 OCR PDF lê letra manuscrita?
Não com confiança. O motor é treinado em texto impresso, então anotações à mão geralmente saem como letras erradas ou são ignoradas. Formulários impressos com respostas à mão funcionam na parte impressa; digite você mesmo as respostas manuscritas se elas precisarem ser pesquisáveis.
O pdf24 OCR PDF muda a aparência da minha digitalização?
Não. As páginas originais ficam exatamente como estavam; as palavras reconhecidas são acrescentadas como texto invisível sobre as letras correspondentes. Só o tamanho do arquivo cresce um pouco, de 2,46 MB para 2,60 MB no nosso contrato de 5 páginas, principalmente por causa da fonte embutida.
O pdf24 OCR PDF salva texto simples?
Sim. Escolha Texto simples (.txt) como resultado para receber só as palavras reconhecidas, com uma linha --- n --- entre as páginas. Nosso contrato de 5 páginas deu um arquivo de texto de 14 KB com cerca de 2.591 palavras, pronto para colar num documento ou numa ferramenta de tradução.
Quais arquivos o pdf24 OCR PDF aceita?
PDFs digitalizados e imagens avulsas que o seu navegador consegue abrir, como JPG, PNG e WebP. Um PDF é lido página por página a cerca de 300 dpi; uma imagem vira uma página. Para várias fotos, junte-as antes com Digitalizar para PDF e depois rode o OCR nesse PDF.
Qual a precisão do pdf24 OCR PDF?
Numa digitalização limpa e reta de texto impresso, ele é muito preciso: todas as 2.565 palavras alfabéticas do nosso contrato de 5 páginas coincidiram com a fonte. A precisão cai com borrões, letras pequenas, páginas tortas, carimbos e o idioma errado, e imagens sem texto podem gerar palavras sem sentido.
O pdf24 OCR PDF reconhece árabe?
Sim. Escolha árabe como idioma; a camada de texto é gravada com uma fonte árabe embutida. O reconhecimento do árabe é mais sensível à qualidade da digitalização do que o texto latino, então uma digitalização nítida de 300 dpi importa ainda mais. Páginas mistas de árabe e inglês podem perder parte da segunda escrita.
Por que o pdf24 OCR PDF não encontrou texto?
Normalmente o idioma está errado, a página está de cabeça para baixo ou de lado, ou a digitalização está borrada demais. Gire as páginas antes, escolha o idioma certo e tente de novo. Se o PDF já tem camada de texto, o OCR não é necessário: Copiar texto do PDF o lê diretamente.
Posso usar o pdf24 OCR PDF no celular?
Sim, nas versões atuais do Chrome, Safari, Edge e Firefox. O OCR é exigente, então um celular demora mais que um computador e precisa manter a tela ligada. Comece com poucas páginas; para digitalizações longas, um computador é a escolha mais confortável.
Quem faz a ferramenta pdf24 OCR PDF?
A equipe do pdf24tools. O pdf24tools é um site independente e não é afiliado ao PDF24 nem à Geek Software GmbH. Nossa página de OCR usa o motor de código aberto Tesseract dentro do seu navegador; esta página o descreve apenas a partir dos nossos próprios testes, com os nossos próprios arquivos.
Mais ferramentas e guias de pdf24 OCR PDF
pdf24 OCR PDF: fontes
- Optical character recognition — Wikipedia
- Tesseract (software) — Wikipedia
- File API — MDN Web Docs