pdf24 OCR funktioniert nicht bei meinem Scan: warum?
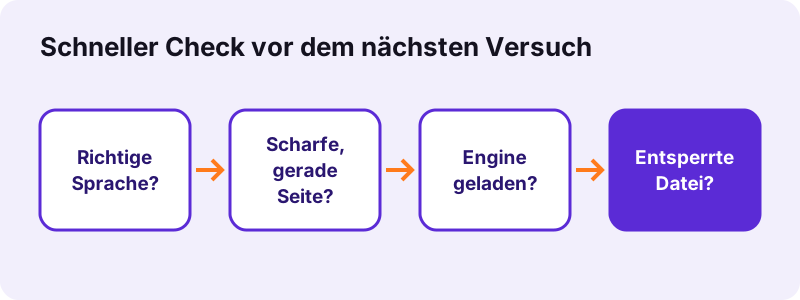
Wenn OCR bei einem Scan nicht funktioniert, sieht die Engine meist keine klaren Buchstaben: Die Seite ist zu klein oder unscharf, gedreht, in einer anderen Sprache als der gewählten oder handgeschrieben. Seltener wurde die Engine selbst nie fertig geladen, weil ein Netzwerkfilter ihren Download blockiert hat, oder die Datei ist passwortgeschützt.
| Symptom | Wahrscheinlichste Ursache | Lösung |
|---|---|---|
| Es wurde kein Text erkannt | Zu wenige Pixel, gedrehte Seite oder falsche Sprache | Mit 300 dpi neu scannen, drehen, Sprache einstellen |
| Text voller Fehler | Geringe Auflösung oder Akzente einer anderen Sprache | Höhere Auflösung, passende Sprache |
| Hängt bei „OCR-Engine wird geladen“ | Engine-Download blockiert oder offline | cdn.jsdelivr.net erlauben, neu verbinden |
| Passwortmeldung | Öffnungspasswort gesetzt | Passwort entfernen mit dem Passwort |
| Zufällige Buchstaben bei einem Foto | Bild enthält keinen Text | OCR nur für Dokumente nutzen |
Arbeite die Tabelle von oben nach unten ab. Bei unseren Testscans erklären die ersten beiden Zeilen die meisten Fälle, und beide sind in unter einer Minute behoben: Sprache umstellen oder ein winziges, verschwommenes Bild durch ein schärferes ersetzen. pdf24 OCR funktioniert nicht trotz dieser beiden Schritte? Dann prüfe die übrigen Zeilen.
pdf24 OCR funktioniert nicht: zuerst die Sprache prüfen
Die OCR-Seite wählt die Sprache der Website vor, die du geöffnet hast, auf dieser Website also Deutsch. Ein französisches, englisches oder türkisches Dokument, das als Deutsch erkannt wird, verliert Akzente und viele Wörter. Wähle vor dem Klick die Sprache des Dokuments aus den 11 Sprachen der Liste.
pdf24 OCR funktioniert nicht bei gedrehten Seiten
Seitlich oder kopfüber gescannte Seiten liefern wenig oder keinen Text. Richte sie mit Seiten drehen auf, lade die gedrehte Kopie herunter und lass OCR über diese Datei laufen. Prüfe jede Seite, denn eine einzige gedrehte Seite in einem langen Scan übersieht man leicht.
pdf24 OCR funktioniert nicht bei Handschrift
Die Engine ist auf gedruckten Text trainiert. Saubere Druckbuchstaben klappen manchmal; verbundene Schreibschrift ergibt meist falsche Wörter oder gar nichts. Das ist eine Grenze des Erkennungsmodells, keine Einstellung, die du ändern kannst, also tippe kurze handschriftliche Notizen lieber ab.
pdf24 OCR funktioniert nicht: Tipp für Handyfotos
Halte das Handy gerade über die Seite, füll das Bild mit dem Papier und nutze Tageslicht. Schatten über dem Text und ein schräger Winkel verwirren die Engine mehr als eine etwas geringere Auflösung. Unser Tool Scannen kann das Foto vorher mit seinem Dokumentfilter aufbereiten.
Erklärt die Auflösung, warum pdf24 OCR funktioniert nicht?
Die Auflösung ist der häufigste Grund, warum OCR schlecht arbeitet. Unser Rechnungsscan mit 1654 × 2339 Pixeln ergab etwa 55 richtige Wörter. Auf ein Drittel verkleinert, fand die Erkennung noch 53 Wörter, aber mit Fehlern wie 2550 statt 25,50. Bei einem Fünftel der Größe kamen nur 3 Wörter zurück, alle unbrauchbar.
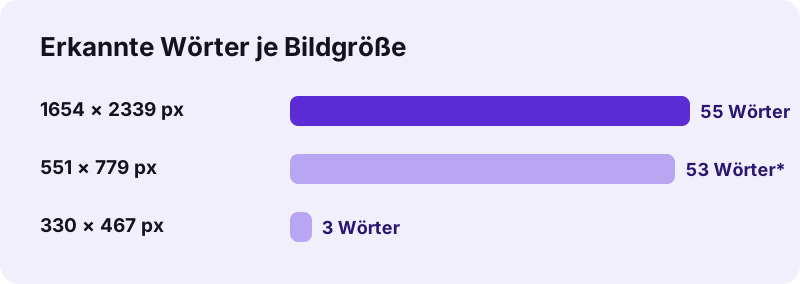
| Bildgröße | Datei | Wörter | Zeit | Qualität |
|---|---|---|---|---|
| 1654 × 2339 px | 72 KB | etwa 55 | 4,0 s | Richtig |
| 551 × 779 px | 33 KB | etwa 53 | 2,8 s | Allas Trading, 2550, 309 |
| 330 × 467 px | 15 KB | etwa 3 | 1,8 s | Unbrauchbar |
„Image resolution is the level of detail of an image. (Die Bildauflösung ist der Detailgrad eines Bildes.)“
PDF-Seiten werden vor der Erkennung mit etwa 300 dpi gerendert, aber das holt keine Details zurück, die ein schlechter Scan nie hatte. Scanne neu mit 300 dpi oder fotografiere die Seite aus geringerem Abstand.
pdf24 OCR funktioniert nicht und hängt beim Laden: was tun?
Wenn die OCR bei „OCR-Engine und Sprachdaten werden geladen“ hängt, konnte der Browser die Engine-Dateien nicht herunterladen. Engine und Sprachpakete kommen bei der ersten Nutzung von cdn.jsdelivr.net. Firewalls in Schulen und Büros, strenge Werbeblocker oder eine abgebrochene Verbindung stoppen diesen Download; dein Dokument ist nie Teil davon.
- Achte auf die Prozentzahl: Bleibt sie eine Minute lang bei 0 %, ist der Download blockiert.
- Erlaube
cdn.jsdelivr.netin deinem Blocker oder probiere ein anderes Netzwerk. - Lade die Seite nach dem Neuverbinden neu; eine halb geladene Engine setzt nicht fort.
- Der erste Lauf auf einem Gerät ist der langsamste; spätere Läufe nutzen die zwischengespeicherten Dateien.
In unseren Tests dauerte der erste OCR-Lauf samt Engine-Download 75,1 Sekunden für 5 Seiten und 82,2 Sekunden für 4 schwere Seiten. Zeigt deiner gar keinen Fortschritt, ist die Meldung pdf24 OCR funktioniert nicht ein Netzwerkproblem, kein Dateiproblem.
pdf24 OCR funktioniert nicht und zeigt sinnlosen Text: warum?
Sinnloser Text entsteht, wenn die OCR-Engine Buchstaben in einem Bild lesen will, das keine hat, etwa ein Foto, ein Logo oder ein Muster. Unser Testfoto ganz ohne Text lieferte in 48,1 Sekunden trotzdem etwa 494 Wörter Rauschen. Die Wortzahl allein beweist also nicht, dass die Erkennung funktioniert hat.
Öffne das Ergebnis immer und lies ein paar Zeilen gegen das Original. Markiere in der durchsuchbaren PDF einen Satz und füge ihn in einen Texteditor ein; vergleiche in der .txt-Ausgabe Namen und Zahlen. Hat ein gemischtes Dokument Fotoseiten, entferne sie vor der OCR mit Seiten löschen.
Schnell beurteilst du die Meldung pdf24 OCR funktioniert nicht, indem du die Textausgabe an einer Seite testest. Zeigt die .txt echte Wörter deiner Seite, funktioniert die Erkennung und nur die Quellseiten müssen aufbereitet werden; zeigt sie zufällige Buchstaben, hat die Seite keinen für die Engine lesbaren Text.
pdf24 OCR funktioniert nicht bei gesperrten oder beschädigten PDFs
Eine gesperrte PDF stoppt die OCR mit dem Hinweis, dass die Datei passwortgeschützt ist. Entferne das Öffnungspasswort mit Passwort entfernen, mit dem Passwort, das du kennst, und lass OCR dann über die entsperrte Kopie laufen. Eine beschädigte Datei, die kein Reader öffnet, lässt sich oft vorher mit PDF reparieren neu aufbauen; unsere kaputte Testdatei war in 0,8 Sekunden repariert.
- Passwort entfernen: entfernt Druck- und Kopiersperren ohne Passwort; entfernt ein Öffnungspasswort, wenn du es eingibst.
- PDF reparieren: baut einen kaputten Dateiindex neu auf, damit die Seiten wieder lesbar sind.
- Danach kehrst du mit der reparierten Kopie zu OCR zurück.
Öffnet sich die Kopie ohne Passwort, ist pdf24 OCR funktioniert nicht bei dieser Datei meist gelöst; die übrigen Ursachen sind die Bildursachen von oben.
pdf24 OCR funktioniert nicht, weil die Datei zu groß ist?
Große Scans machen OCR langsam, nicht kaputt, weil jede Seite mit etwa 300 dpi neu gezeichnet und auf deinem eigenen Gerät erkannt wird. Unser 4-seitiger Scan mit 8,07 MB brauchte 82,2 Sekunden. Ein Scan mit 100 Seiten kann auf dem Handy viele Minuten dauern und abbrechen, wenn dem Browser der Speicher ausgeht oder der Tab einschläft.
Teile lange Scans mit PDF trennen in Teile von 10 bis 20 Seiten, erkenne jeden Teil und verbinde die Ergebnisse mit PDF zusammenfügen. Lass den Bildschirm an und den Tab im Vordergrund, solange gearbeitet wird. pdf24 OCR funktioniert nicht wegen eines Speicherlimits? Dann schafft ein Laptop dieselbe Datei viel schneller als ein Handy.
Der Datenschutz bleibt bei all diesen Lösungen unberührt: Die Datei wird mit der File API gelesen und lokal verarbeitet, und unsere Anfrageprotokolle zeigten 0 hochgeladene Bytes.
pdf24 OCR funktioniert nicht: häufige Fragen
pdf24 OCR funktioniert nicht und meldet, es wurde kein Text erkannt: warum?
Die Engine hat keine Buchstaben gefunden, die sie lesen kann. Prüfe, ob die Sprache zum Dokument passt, ob die Seite gerade steht und ob der Scan scharf ist. In unserem Test ergab eine auf 330 × 467 Pixel verkleinerte Seite nur 3 Wörter, der Scan in voller Größe dagegen etwa 55 richtige.
pdf24 OCR funktioniert nicht wegen meines Browsers?
Selten. OCR braucht einen aktuellen Browser mit WebAssembly und Web Workers, die Chrome, Edge, Firefox und Safari alle unterstützen. Sehr alte Versionen oder Erweiterungen, die Worker oder Skripte von cdn.jsdelivr.net blockieren, verhindern den Start der Engine. Aktualisiere den Browser oder probiere ein privates Fenster ohne Erweiterungen.
pdf24 OCR funktioniert nicht wegen einer Firewall?
Ja, das kommt vor. Engine und Sprachdaten werden beim ersten Mal von cdn.jsdelivr.net geladen. Filter in Firmen, Schulen oder öffentlichen WLANs blockieren diese Adresse manchmal, und der Fortschritt bleibt dann bei 0 %. Probiere ein anderes Netzwerk oder bitte die Administration, sie freizugeben; dein Dokument wird nirgendwohin gesendet.
pdf24 OCR funktioniert nicht bei Handschrift: warum?
Das Erkennungsmodell ist auf gedruckte Buchstaben trainiert, daher ergibt Schreibschrift meist falsche Wörter oder gar nichts. Saubere Großbuchstaben klappen manchmal. Es gibt keine Einstellung, die die Erkennung von Handschrift verbessert, deshalb ist Abtippen bei kurzen handschriftlichen Notizen schneller als das Korrigieren der Ausgabe.
pdf24 OCR funktioniert nicht: wurde meine Datei hochgeladen?
Nein. Zu keinem Zeitpunkt wird etwas hochgeladen: Der Browser öffnet deine Datei lokal und führt die Erkennung in der Seite aus. Unsere Anfrageprotokolle zeigten keine POST-Anfrage. Heruntergeladen werden nur die Engine und die Sprachdaten, und die enthalten nichts aus deinem Dokument.
pdf24 OCR funktioniert nicht richtig bei Umlauten und Akzenten?
Umlaute und Akzente gehen schief, wenn die gewählte Sprache nicht zur Sprache des Dokuments passt. Das englische Modell erwartet keine Zeichen wie ä, é oder ç und ersetzt oder streicht sie. Wähle Deutsch, Französisch, Spanisch, Portugiesisch, Italienisch, Türkisch oder Vietnamesisch passend zum Text und starte erneut.
Wie lange darf OCR dauern, bevor ich denke, pdf24 OCR funktioniert nicht?
Rechne am Laptop mit etwa 15 bis 20 Sekunden pro gescannter Seite, plus dem ersten Engine-Download. Unser 5-seitiger Scan brauchte 75,1 Sekunden und unser schwerer 4-seitiger Scan 82,2 Sekunden. Bewegt sich der Seitenzähler mehrere Minuten lang nicht, lade die Seite neu und probiere eine kürzere Datei.
pdf24 OCR funktioniert nicht: hilft das Drehen der Seiten?
Oft ja. Seitliche und kopfüber liegende Seiten liefern wenig oder keinen Text. Richte sie mit Seiten drehen auf, speichere die neue Kopie und lass OCR darüber laufen. Gemischte Scans, in denen nur eine Seite gedreht ist, sind häufig, prüfe also vorher jede Seite in der Vorschau.
pdf24 OCR funktioniert nicht beim Foto eines Schilds: warum?
OCR ist für Dokumente gebaut: dunkler Text auf hellem, flachem Hintergrund. Fotos von Schildern, Bildschirmen oder Verpackungen haben Perspektive, Spiegelungen und dekorative Schriften, was schlechte Ergebnisse liefert. Ein Foto ganz ohne Text ergab in unserem Test sogar etwa 494 Wörter Rauschen.
pdf24 OCR funktioniert nicht bei arabischem Text?
Arabisch ist eine der 11 Sprachen, daher klappt es, wenn Arabisch gewählt ist und der Druck klar ist. Kleine, kontrastarme oder dekorative arabische Schriften verringern die Genauigkeit, wie in jeder Sprache. Nutze einen scharfen Scan mit etwa 300 dpi und prüfe den erkannten Text gegen das Original.
pdf24 OCR funktioniert nicht auch auf anderen OCR-Seiten?
Für andere Dienste können wir nicht sprechen. pdf24tools ist unabhängig und steht in keiner Verbindung zu PDF24 oder der Geek Software GmbH; diese Anleitung behandelt unsere eigene OCR, die die Open-Source-Engine Tesseract in deinem Browser ausführt. Die Lösungen hier beruhen auf unseren Messungen vom 2. November 2026.
pdf24 OCR funktioniert nicht bei passwortgeschützten Dateien?
Richtig. Eine Datei, die zum Öffnen ein Passwort braucht, stoppt mit dem Hinweis, es zu entfernen. Nutze Passwort entfernen mit dem Passwort, das du kennst, und lass OCR dann über die entsperrte Kopie laufen. Dateien, die nur Druck- oder Kopiersperren haben, lassen sich ohne Passwort entsperren.
pdf24 OCR funktioniert nicht nach jeder Lösung: was nun?
Probiere die Textausgabe statt PDF, um zu sehen, was die Engine wirklich liest, teste eine einzelne saubere Seite und nimm einen Laptop statt eines Handys. Scheitert eine saubere, gerade Seite mit 300 dpi in der richtigen Sprache trotzdem, schreib uns über die Kontaktseite mit einer Beschreibung der Datei.
Weitere pdf24 OCR funktioniert nicht Tools und Anleitungen
pdf24 OCR funktioniert nicht: Quellen
- Texterkennung — Wikipedia
- Image resolution — Wikipedia
- Tesseract (Software) — Wikipedia
- File API — MDN Web Docs